《秘書可芸,請指教》製作全紀錄
一個人、沒有劇組,怎麼把一部 AI 劇從企劃拍到上架。工具、流程、成本,還有踩過的每一個坑,全部公開。
How one person, without a crew, took an AI drama from proposal to release: tools, workflow, costs and every pitfall along the way. (Full text in Traditional Chinese.)
給創作者的話
For creators
沒有資源,也能把故事拍出來寫給正在等別人點頭的你
- 我也等過。
寫好企劃書、找到願意簽意向書的演員、申請補助、投稿給製作公司,然後等。等到的大多是沒有回音。如果你也正在等,我想分享這一年我是怎麼不再等下去的。
- 先有故事,工具才派得上用場。
AI 能畫出很美的畫面,卻不會替你決定可芸生氣時該叫煦晨什麼。開拍前,我先把人物、世界觀、二十二集的大綱都寫清楚。故事越完整,工具越好用;故事是空的,畫面再美也撐不起來。
- 把一個劇組,拆成一個人做得完的步驟。
定裝:先把角色的臉和服裝固定下來。勘景:每個場景都找真實照片當參考,高雄才不會被畫成別的城市。分鏡:一鏡一句台詞,先排好再拍。畫格先審:每一鏡開拍前先看靜態畫面,不對就重畫,不浪費生成額度。後面的配音、配樂、剪輯、字幕,也都一步一步做。
- 先求有,再求好。
資源有限,就把力氣花在故事最需要的地方。臉跑掉、台詞說錯,一定要修;小瑕疵就記下來,先讓故事完成。觀眾記得的是故事,不是第幾秒的那根手指。
- 一個人,不代表沒有夥伴。
這部劇的剪輯、字幕、上架和官網,有很大一部分是我和 AI 助手一起完成的。它幫我查資料、提醒我漏掉的細節,甚至會指出我記錯的事。但每一個「要不要」,最後都由我決定。
- 誠實告訴觀眾,這是 AI 做的。
每一集都標示了 AI 製作,演員也標明是虛擬演員。誠實不會讓作品變廉價;觀眾在意的,是你有沒有用心。
- 做出來,讓觀眾決定。
作品放上 YouTube,剪成短片,做一個官網專頁,觀眾自然會用觀看和留言回應你。這些回應,就是當初企劃書裡最缺的東西。
製作流程
Workflow
故事聖經:先寫好故事,再開拍 Story bible
開拍前,我把官網連載的四十多篇原文,整理成一份「故事聖經」:人物的年齡、個性、口頭禪,彼此怎麼稱呼,還有二十二集的分集大綱和每條伏筆在哪一集回收。
之後每一集都照這份文件拍,AI 助手也照這份文件工作。像下面這張「稱呼規則」,就決定了每一句台詞裡,可芸該怎麼叫煦晨。
故事聖經 · 稱呼規則(節錄)
| 可芸叫他 | 什麼時候 | 備註 |
|---|---|---|
| 劍主 | 平常、溫柔或吐槽時 | 半是尊稱,半是調侃 |
| 執行長! | 生氣或數落他時 | 例:「執行長,你知道我繞了幾圈嗎?」 |
| 老闆 | 對他非常失望、刻意公事公辦時 | 第一次出現在 EP09 的爭執 |
| 煦晨 | 只留給最重要的時刻 | 第一次出現在 EP05 |
重點先把規則寫下來,AI 才不會亂改你的角色。
定裝:先把演員的臉固定下來 Casting
可芸和煦晨的臉,來自我先前自製的一支前導片,完全由文字生成,沒有用到任何真人的照片。
AI 每生成一次,都可能換一張臉。所以我先從前導片挑出三張定裝照,再補拍五個角度(側臉、四分之三側、辦公室笑容、戶外黃昏),每個角色八張。之後每一鏡生成時,都附上其中三張臉部參考:正面大頭照,加上左右四分之三側臉。
之後每一鏡都拿定裝照放大比對,臉不像就重做。
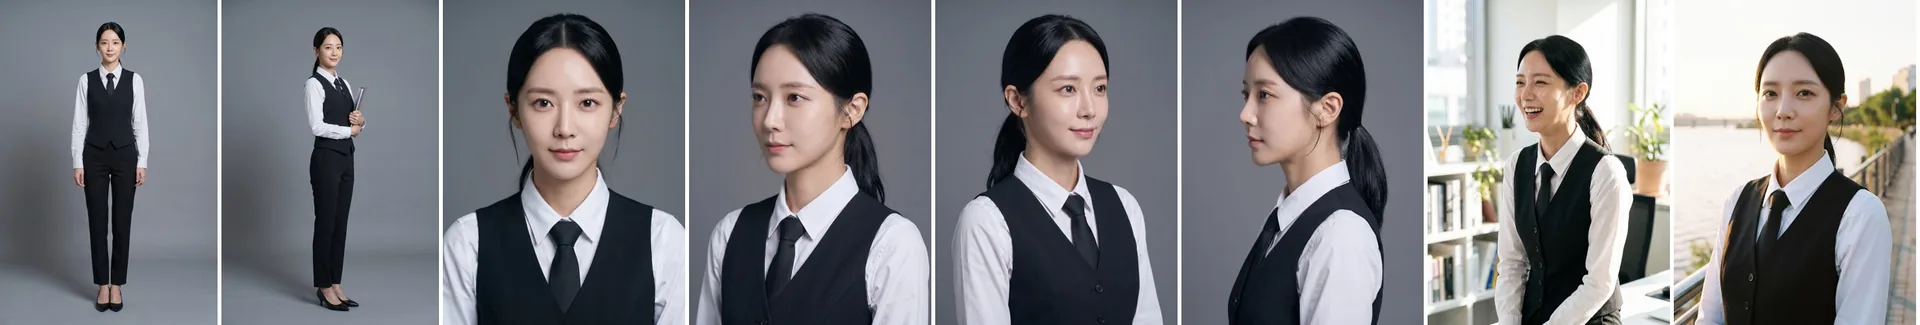
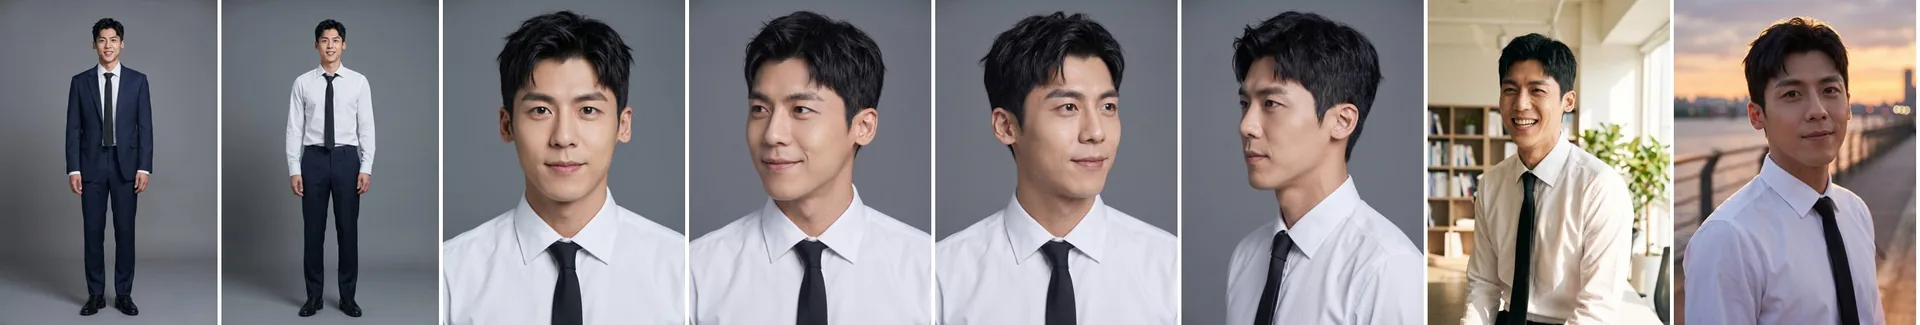
重點臉是一切:先固定,再開拍。
勘景:高雄不能被畫成別的城市 Location scouting
每個場景開拍前,先找可以合法使用的實景照片當參考,只用 CC0 或 CC BY 授權的照片。左邊是高雄展覽館的實景照片,右邊是 EP14 開場的畫面。
常出現的場景,像炎劍常去的愛河咖啡館、愛河步道,則先做「場景定裝」,讓它每次出現都長得一樣。
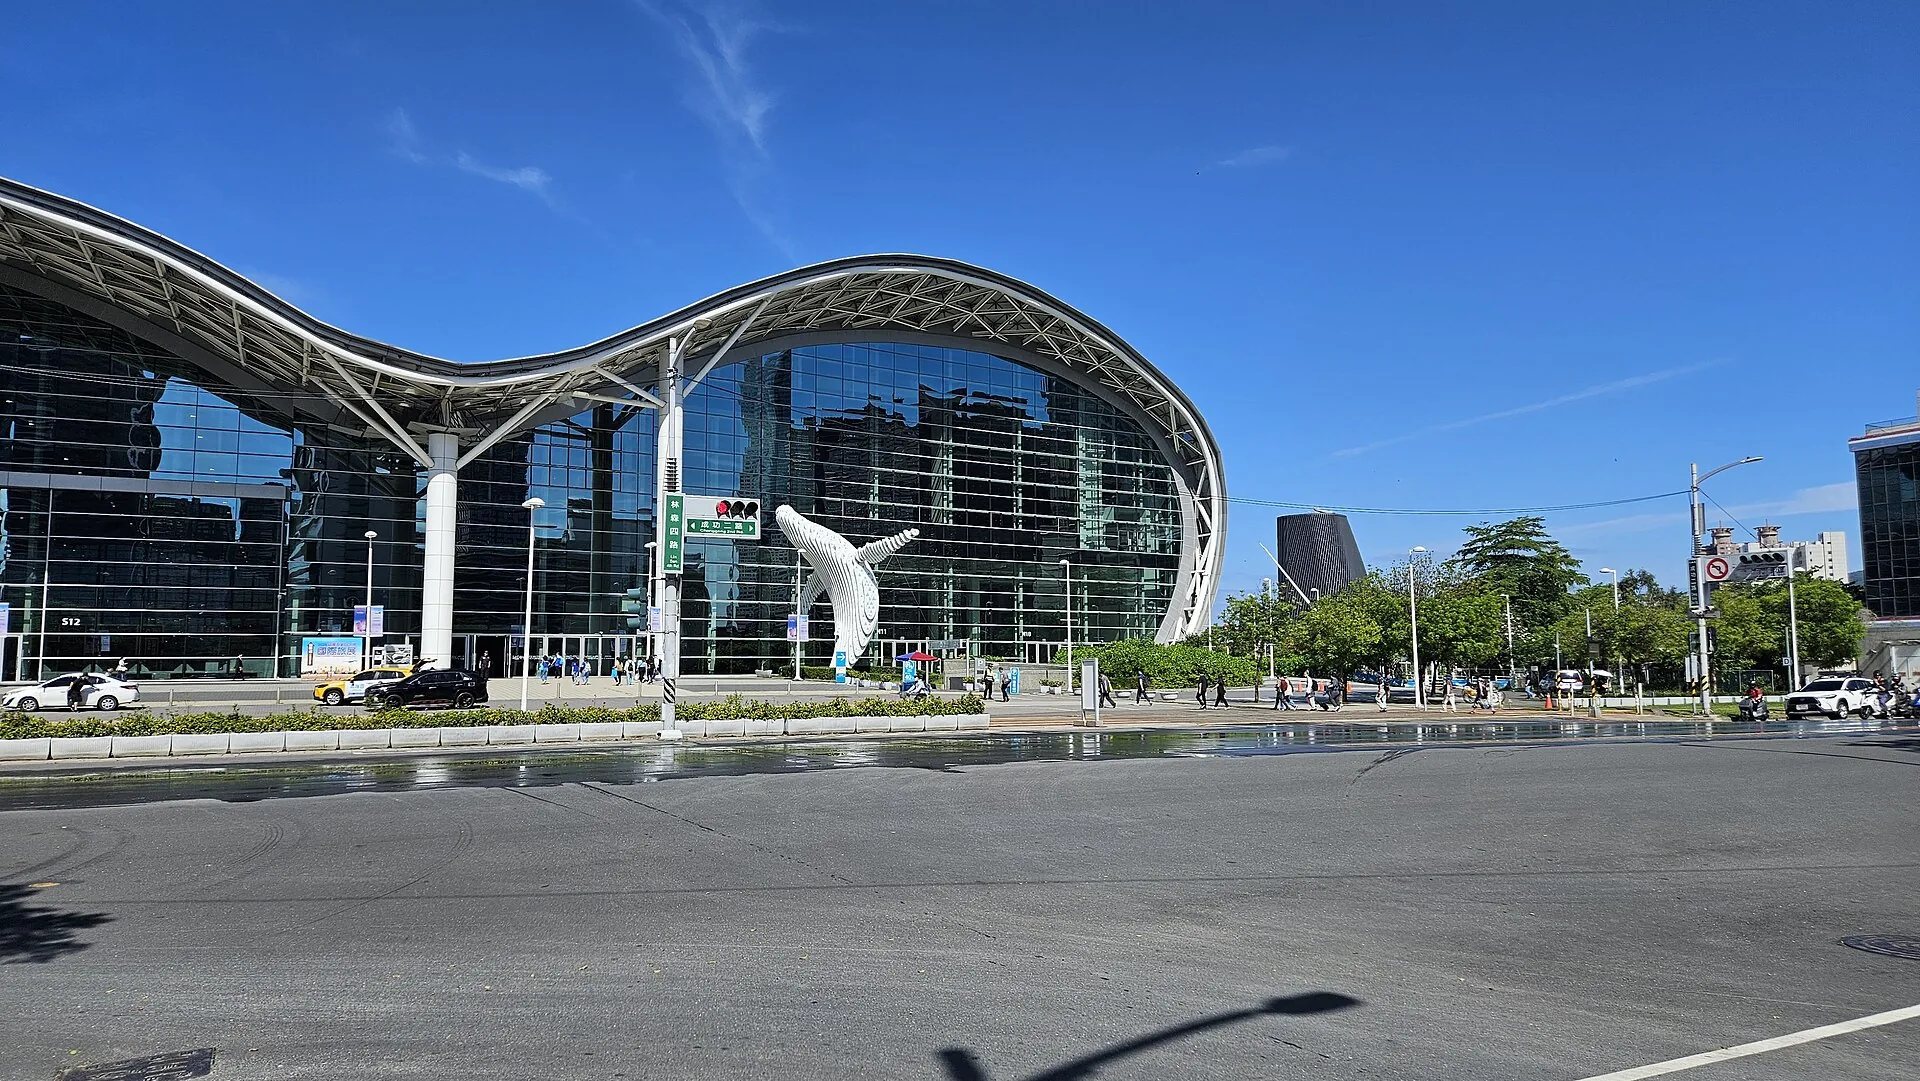
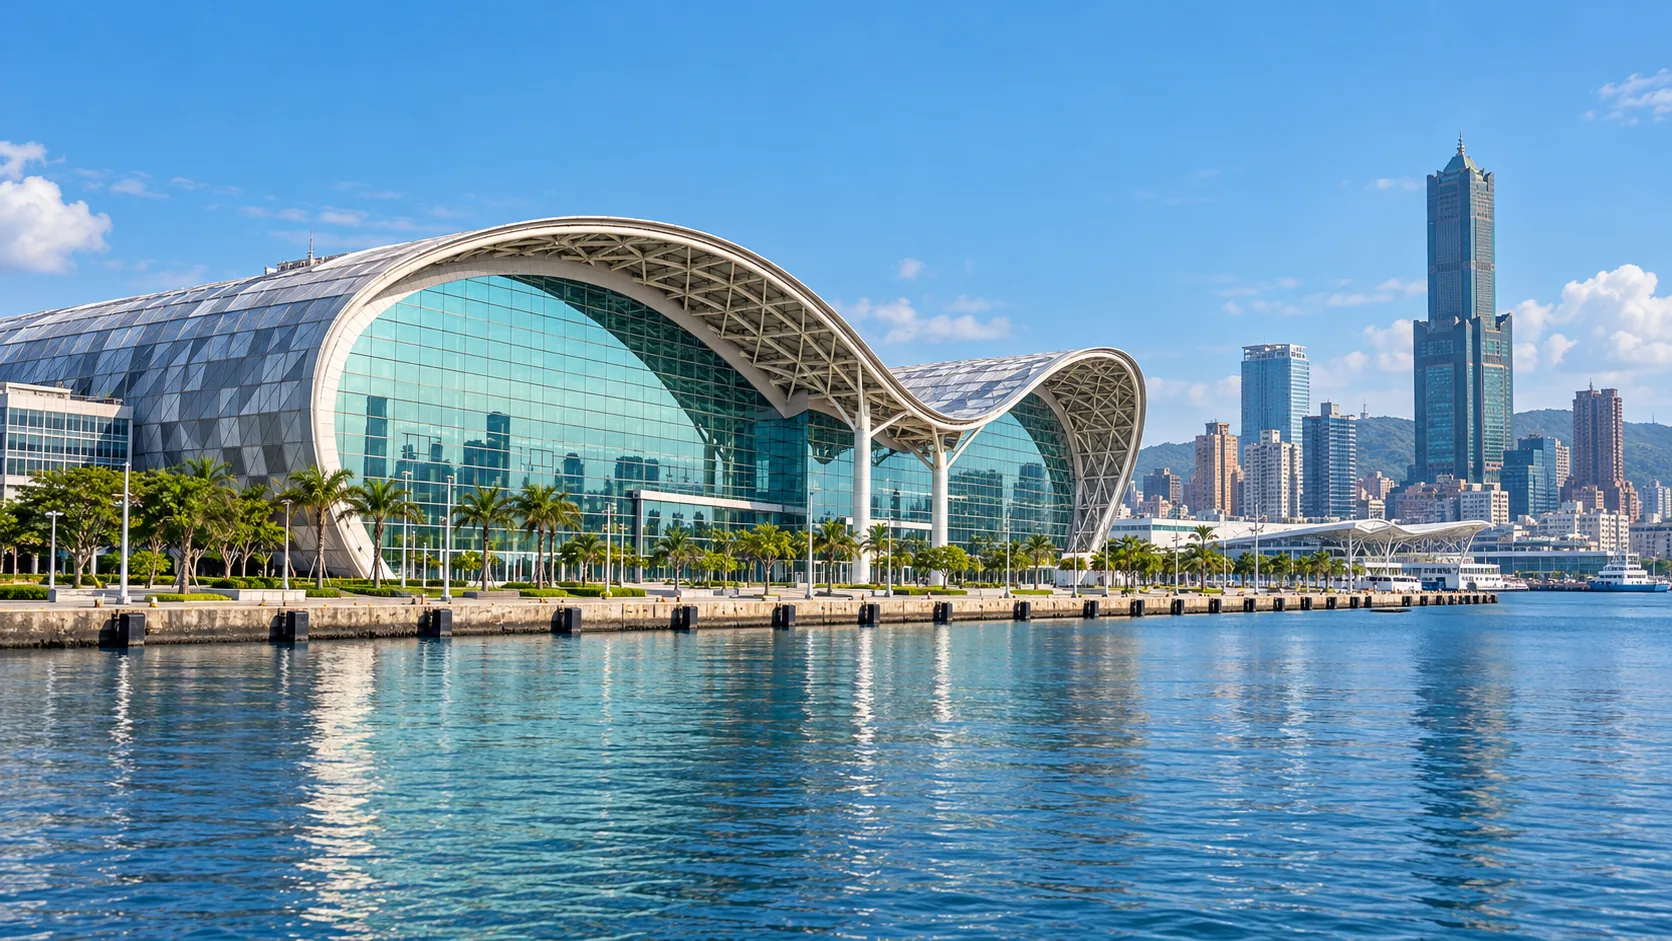
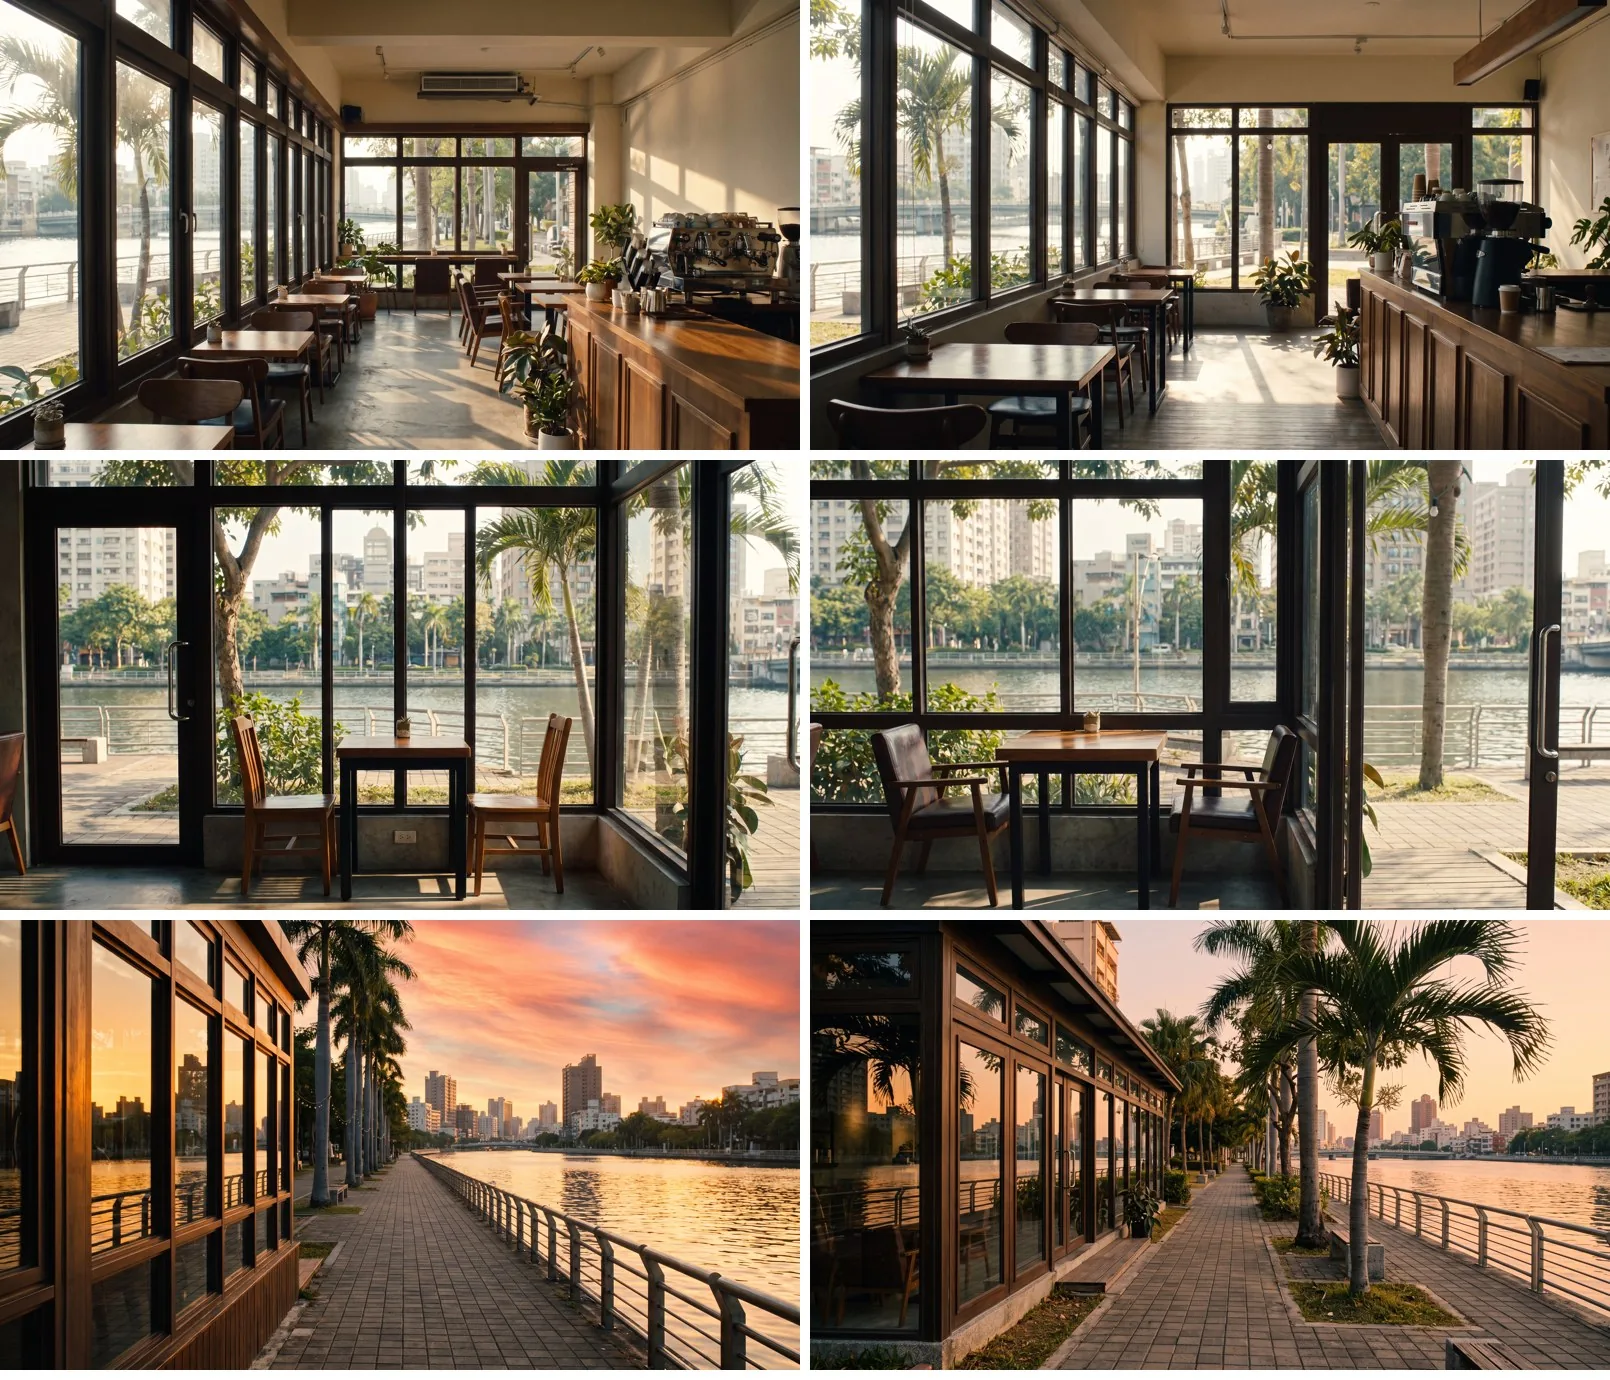
重點沒有合法的照片就換景點,別讓 AI 畫錯城市。
分鏡表:一鏡一句台詞 Storyboard
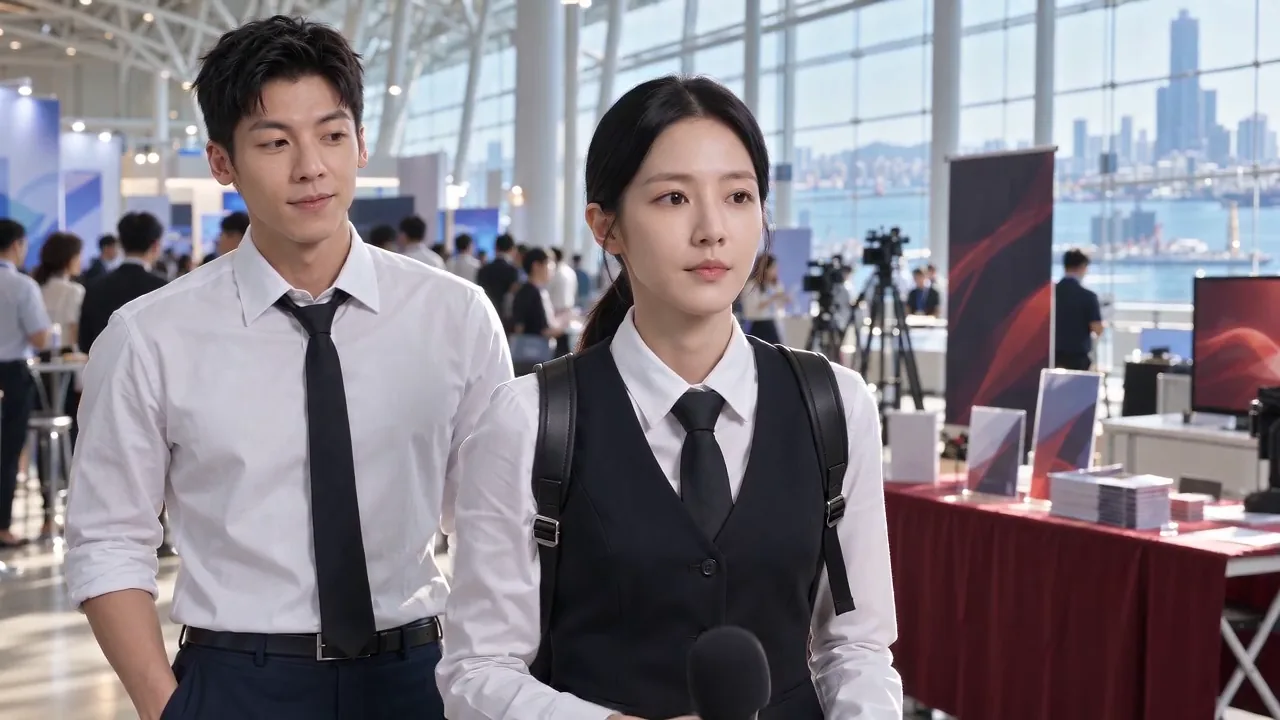
台詞一字不改照原文,每鏡 3~5 秒,台詞說完就切。分鏡表上也標好地點貼紙、讓觀眾喘口氣的「緩和點」,以及哪些鏡頭可以不花點數。下面是 EP14 的一小段。
EP14 分鏡表(節錄)
| 鏡 | 秒 | 地點 | 畫面 | 台詞 |
|---|---|---|---|---|
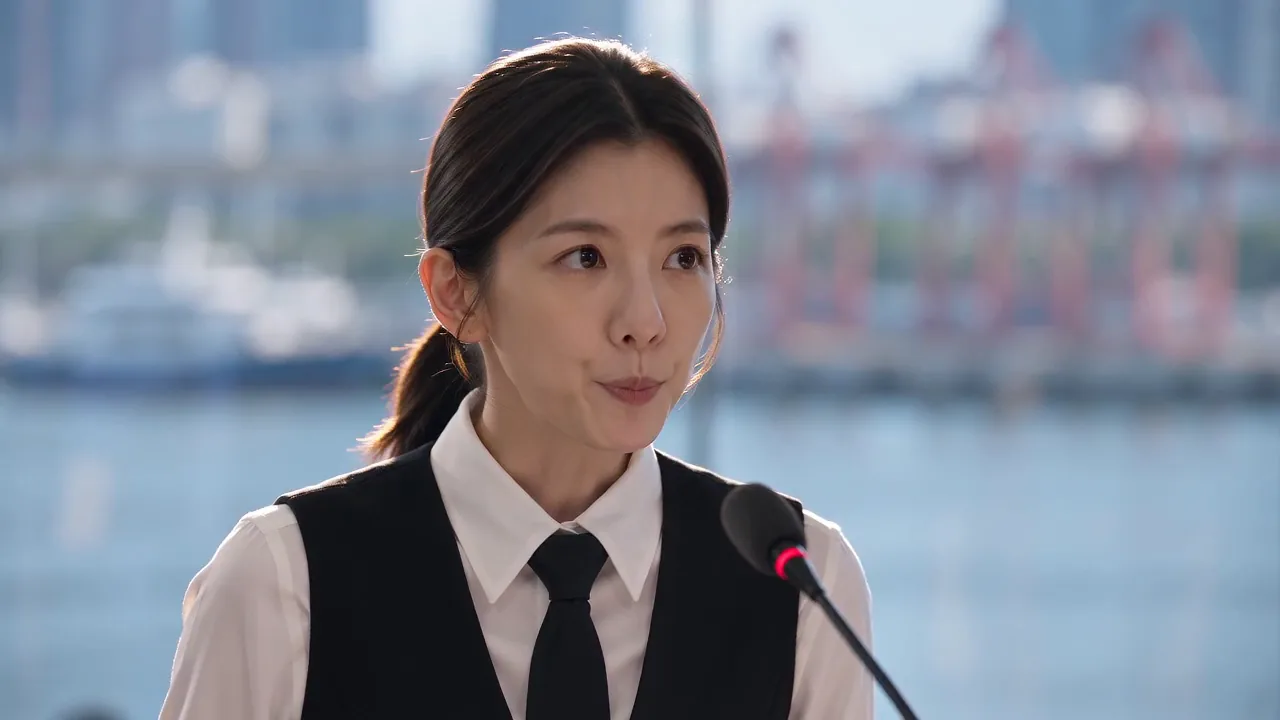
| S18 | 3 | 炎劍攤位 | 林可芸忽然上前一步,淡定接過麥克風。 | (無) |
| S19 | 4 | 炎劍攤位 | 可芸面對鏡頭。 | 「我們承認,我們曾經犯過錯。」 |
| S20 | 4 | 炎劍攤位 | 她的聲音清晰而堅定。 | 「但至少,我們的每一步,都是誠實走來的。」 |
重點一鏡一句台詞,說完就切。
畫格先審,再開拍 Keyframes first
每一鏡先用 OpenAI 的 Codex 畫兩張候選的靜態畫格,我放大檢查臉、手指、服裝和背景,挑一張才送去生成影片。
靜態圖便宜、影片貴。先在畫格階段把錯誤擋下來,是最省點數的做法。
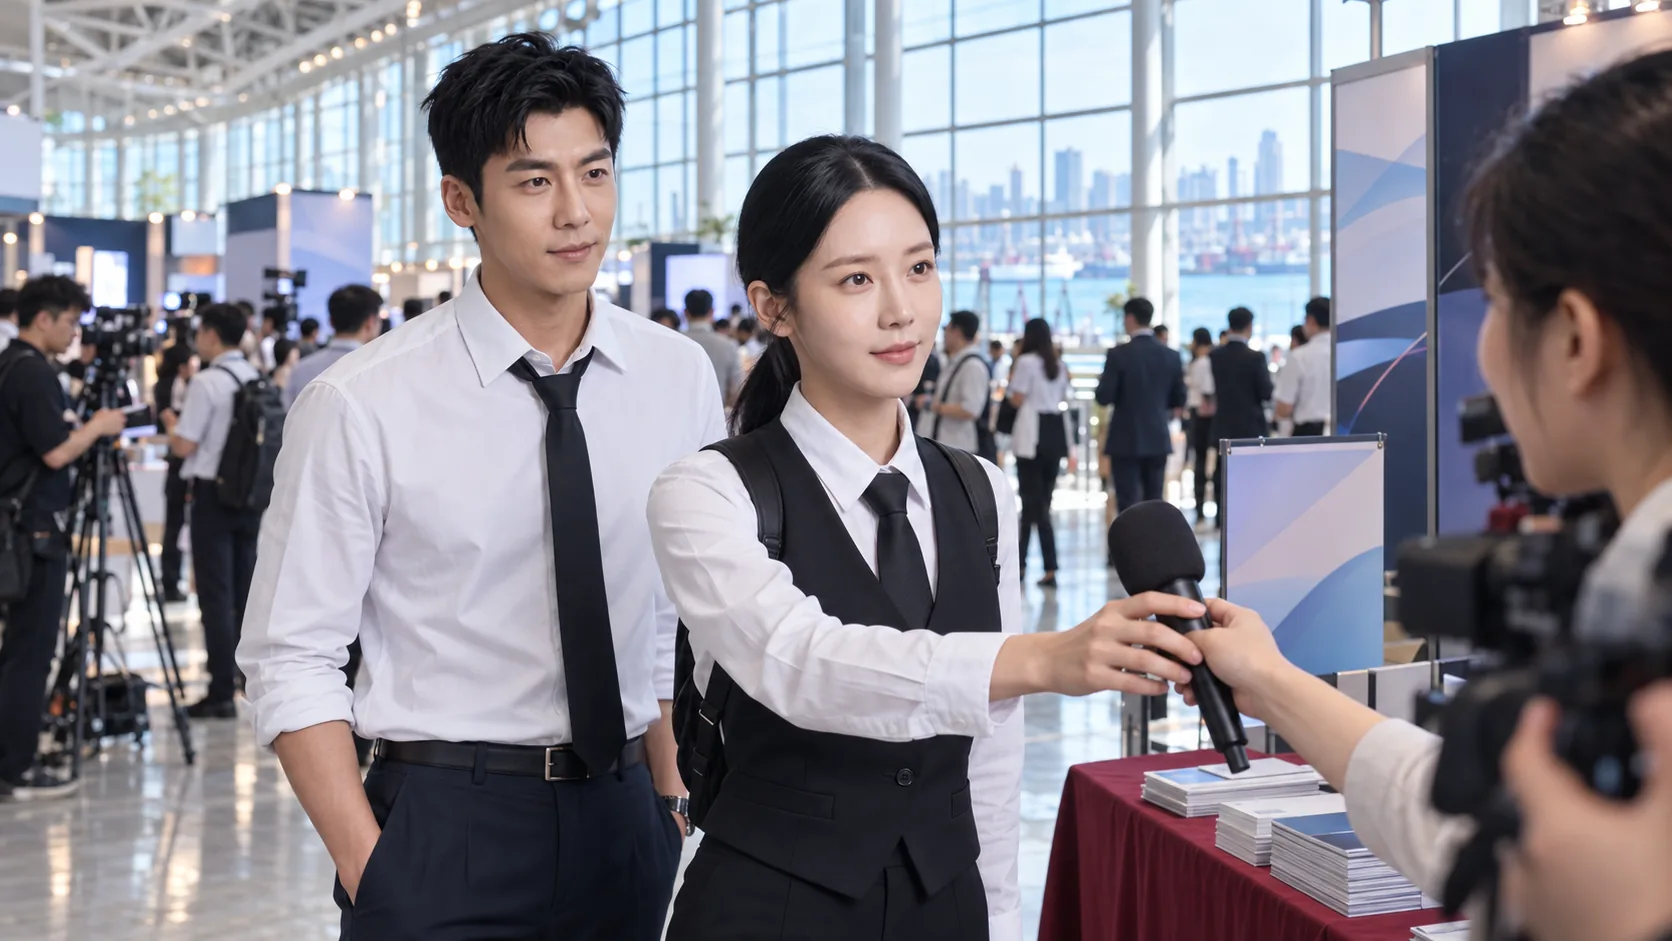
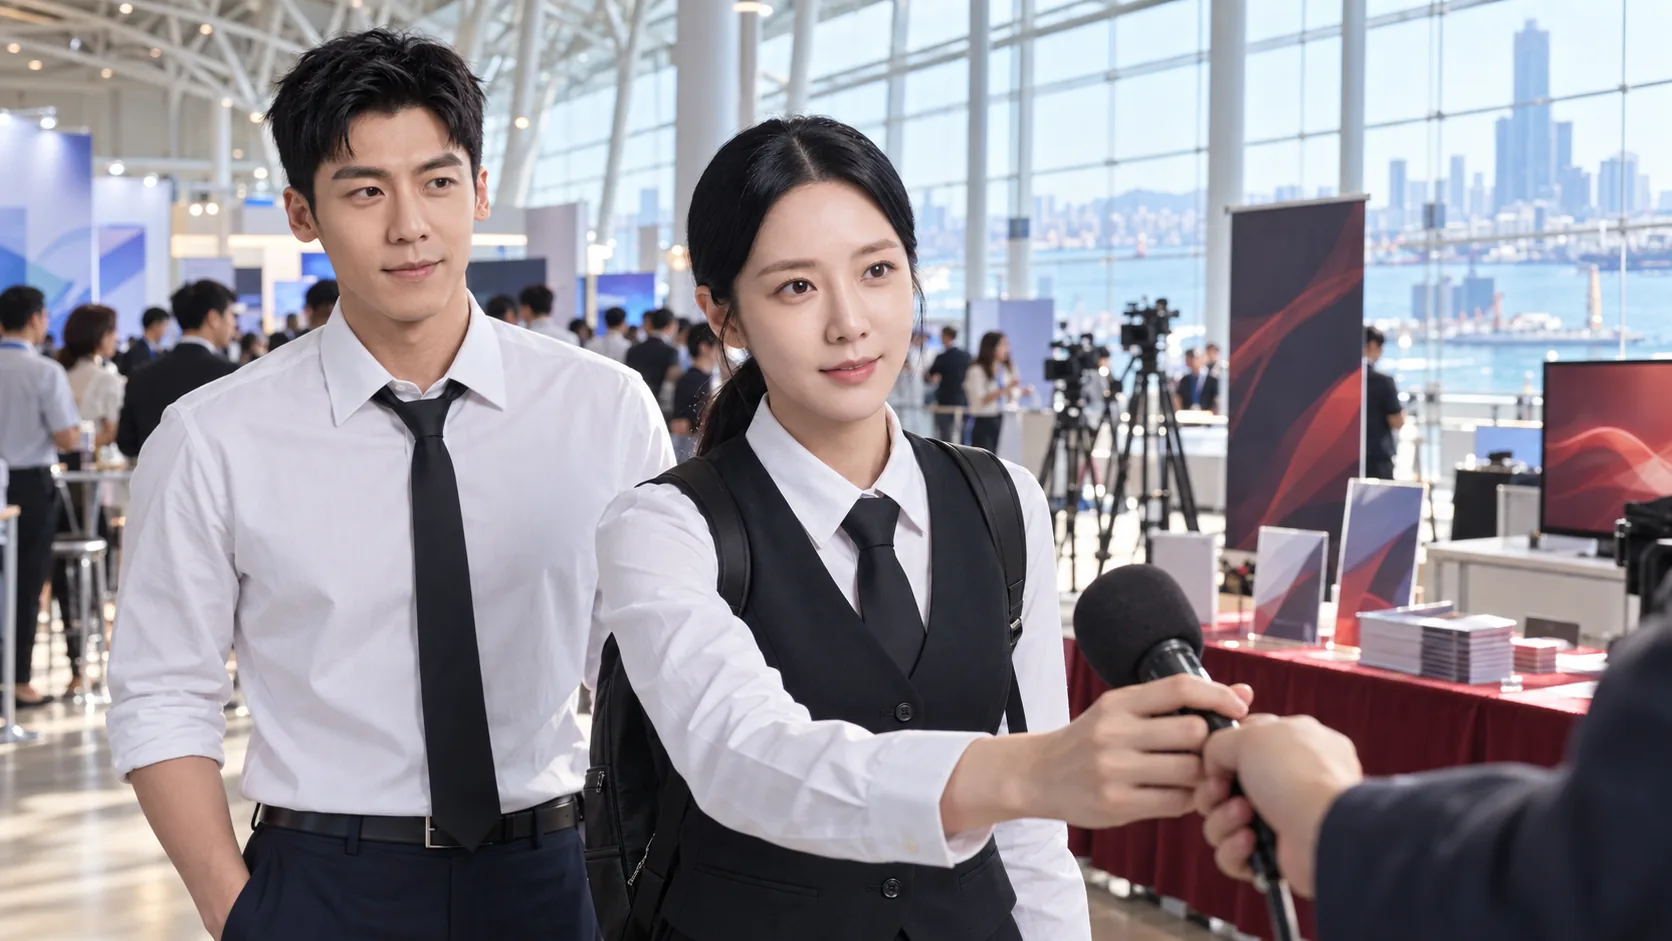
重點靜態圖便宜、影片貴,錯誤要在畫格階段擋下來。
從畫格到影片 From keyframe to video
核准的畫格當作影片的第一格,交給影片模型(Seedance 2.0)生成 4~6 秒的鏡頭。
EP01~EP12 在 Higgsfield 上拍,角色的「聲音卡」直接念台詞,嘴型和聲音一次到位。720p 拍好,確定要用的鏡頭再升級成 1080p。
重點先拍 720p,確定要用的鏡頭再升 1080p。
EP13、EP14:為了不浪費點數,換一個平台拍 Why EP13–14 were shot on LitVideo
原因拍完 EP12 時,Higgsfield 的點數已經所剩不多,而另一個平台 LitVideo 的訂閱裡還有點數沒用。為了不浪費這些點數,EP13、EP14 改在 LitVideo 上,用同一個影片模型拍。
代價LitVideo 的首幀模式不能放角色的聲音卡,拍出來的原聲不是可芸和煦晨的聲音。第一版我另外生成配音再對嘴,結果聲音、嘴型、字幕三樣都對不上,整集重來。
解法「換聲」:先把原聲裡的人聲和背景分開,再只把人聲換成角色的音色,最後把背景混回去。因為保留了原本說話的節奏,嘴型自然對得上。
取捨老實說,換聲的品質比 Higgsfield 一條龍的聲音差一些,口音也和前幾集有點不同。這是這兩集的取捨:先把故事說完。
- LitVideo 拍攝影片和嘴型都對,但原聲不是角色的聲音
- 分開人聲與背景Demucs(開源)
- 只換人聲的音色OpenVoice(開源)+早期集數 6 句角色原聲當樣本
- 混回背景、對齊字幕說話節奏不變,嘴型自然對得上
重點換聲保住了嘴型,聲音品質則要有取捨。
聲音與配樂 Sound and music
片頭曲《叮咚!交給我》、片尾曲《微光》由我作詞,用 AI 音樂工具製作。情境配樂(輕快、心動、尷尬、慢動作英雄……)先做成一套全劇共用的曲庫,每集挑著用。
混音的原則是台詞優先。情緒最重的戲,先只留現場聲;到了故事的轉折點,才讓音樂進來。下面是 EP14 的配樂安排。
EP14 配樂安排(全長 2:02)
- 0:08–0:13 片頭曲《叮咚!交給我》
- 0:33–1:16 只留現場聲(當眾嘲諷、記者圍訪)
- 1:16–1:35 心動溫馨(可芸接過麥克風)
- 1:39–1:45 輕快喜劇(平板笑點)
- 1:51–2:01 片尾曲《微光》(下集預告起)
重點情緒最重的戲,先讓音樂安靜。
剪輯與包裝 Editing and packaging
剪輯、字幕、字卡都用程式完成(Python+FFmpeg):AI 助手 Claude 依分鏡表組裝,我逐段審片。字幕依實際發聲的時間逐句對齊,金句放大、改成粉紅色。
片頭品牌閃卡、劇名字標、人物字卡,都是全劇共用的母版。
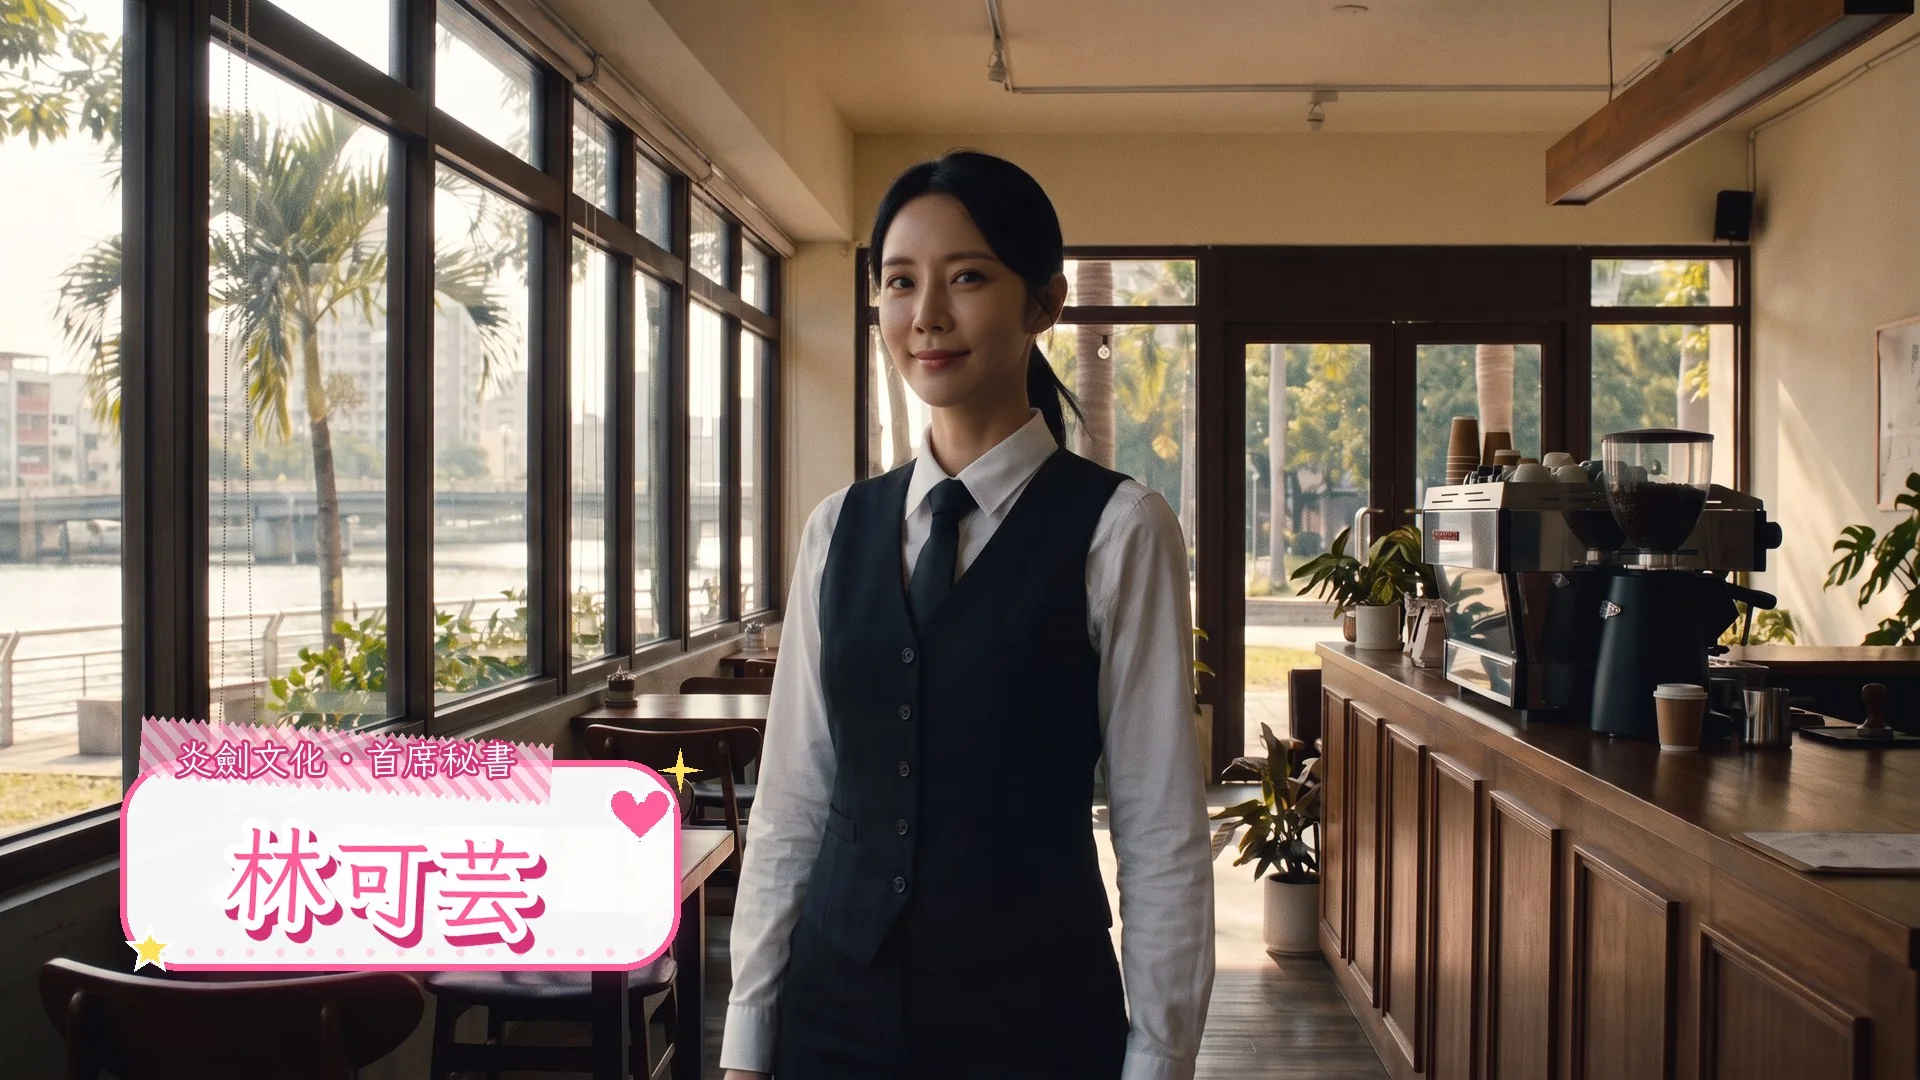
重點做成共用母版,每一集的包裝才會一致。
上架:六種語言、短片與官網 Release
每集正片附上六種語言的字幕與標題說明,每集再剪三支 Shorts(附中英字幕),最後同步到官網專頁。每一支都標示 AI 製作。
- 繁體中文
- 简体中文
- English
- 日本語
- 한국어
- ไทย
- 每集 3 支 Shorts
- 官網專頁
- AI 製作標示
重點每一支都誠實標示 AI 製作。
踩過的坑
Pitfalls
這是這份紀錄最想分享的部分。每一個坑,都寫下發生了什麼、為什麼、後來怎麼解決。
1臉會「慢慢」跑掉
- 發生了什麼
- 同一個角色,一集一集拍下來,眉形、妝感、年紀都悄悄變了。
- 為什麼
- 每一鏡單看都說得過去,用分數檢查也抓不出來。
- 怎麼解決
- 把整集每一鏡的臉放大並排,對照第一季的基準臉一起看;送審時一定看放大圖,縮圖不算。
2參考圖越多,臉越不像
- 發生了什麼
- 想讓畫面更準,給了模型很多參考圖,結果臉反而跑掉。
- 為什麼
- 場景圖和其他人物搶走了模型對臉的注意力。
- 怎麼解決
- 參考圖只放三張臉部特寫,場景參考放在最後。
3手畫反了
- 發生了什麼
- 畫格裡的手變成鏡像:拇指在錯的那一邊。
- 為什麼
- AI 畫手本來就容易出錯,縮圖上又看不出來。
- 怎麼解決
- 推薦畫格前,一定放大檢查掌心方向和拇指位置。
4另外配音再對嘴,三樣都對不上
- 發生了什麼
- EP13 第一版,聲音、嘴型、字幕全部錯位。
- 為什麼
- 另外生成的配音,說話節奏和影片裡的嘴型本來就不同,怎麼平移都救不了。
- 怎麼解決
- 改用「換聲」,保留原本的說話節奏,只換音色。
5換聲的樣本,不是越多越好
- 發生了什麼
- 用了 22 句可芸的原聲當樣本,換出來反而沒有 6 句的像。
- 為什麼
- 句子太多,音色反而被沖淡。
- 怎麼解決
- 從早期集數挑 6 句發音最清楚的原聲當樣本,並實際量測相似度再決定。
6網頁偷偷把提示詞換掉
- 發生了什麼
- EP14 有一鏡,拍出來變成另一個女生站在講台上。
- 為什麼
- 在 LitVideo 改片長時,網頁自動把提示詞還原成上一鏡的內容。
- 怎麼解決
- 先改片長、再填提示詞,送出前把提示詞讀回來比對。拍錯的兩鏡重拍,多花 180 點。
7AI 助手會自作主張
- 發生了什麼
- AI 助手為了遵守一條「肢體距離」規則,把原文的握手改成點頭,把「桌下按住他的手」改成只碰糖包。
- 為什麼
- 規則被它解讀得比原意更寬。
- 怎麼解決
- 規則只照寫明的範圍執行;劇本有疑問時,送審時列出來由我決定,不能先改。
8花了點數訓練角色模型,最後沒用上
- 發生了什麼
- 開拍前花了 50 點,替兩個角色訓練 Higgsfield 的角色臉部模型(Soul ID)。
- 為什麼
- 實際測試時,用它生成的畫面效果不理想,不適合這部劇的拍法。
- 怎麼解決
- 改成每一鏡直接附上三張臉部參考圖。新工具先小量試,確定好用再投入。
9原文和角色設定互相打架
- 發生了什麼
- EP13 可芸鼓勵煦晨時,原文寫的是「老闆」,但依稱呼規則,「老闆」是失望時才用的。
- 為什麼
- 分鏡表送審時,沒有人逐句核對稱呼。
- 怎麼解決
- 現在分鏡表送審前,逐句檢查稱呼;和設定衝突的原文台詞先列出來,由我決定。
10找不到照片,就換景點
- 發生了什麼
- 旗津的彩虹教堂和星空隧道,一直找不到可以合法使用的實景照片。
- 為什麼
- 沒有參考照片,AI 很容易把高雄畫成別的城市。
- 怎麼解決
- 寧可換成有實景照片可參考的旗後燈塔和彩色渡輪,也不畫錯高雄。
11YouTube 標題超過 100 字,不會報錯
- 發生了什麼
- 英文標題貼上去、按下儲存,看起來成功了,其實沒有存進去。
- 為什麼
- YouTube 標題有 100 字元上限,超過時不一定會提示。
- 怎麼解決
- 上架後一定回頭重新讀一次,確認真的存進去了。
12官網自動抓不到新集數
- 發生了什麼
- EP14 上架了,官網專頁卻一直沒出現。
- 為什麼
- 播放清單的公開資料只給前 15 支,EP14 剛好是第 16 支。
- 怎麼解決
- 每集上架當天,主動把新集數加進專頁;自動抓取只當備援。
成本與工具
Costs and tools
💰 大約花了多少點數
| Higgsfield 拍一集(約 20 鏡) | 約 470 點(Seedance 2.0、720p,約 4.5 點/秒) |
|---|---|
| 補拍定裝照 | 20 點,只需要做一次 |
| 升級成 1080p | 每鏡約 1 點 |
| 靜態畫格 | 在 Codex 訂閱內,不另外扣點 |
| LitVideo 拍一集(EP13、EP14) | 約 2,200~2,300 點(含重拍;4 秒一鏡 80 點、5 秒 100 點) |
| 換聲、剪輯、字幕、六語翻譯 | 在自己的電腦上處理,不花點數 |
兩個平台的「點數」單位不同,不能直接相加比較。用到的付費訂閱:Higgsfield Ultra、LitVideo、ChatGPT Pro(Codex)、Claude Max。
🧰 用到的工具
| Higgsfield | 影片生成(Seedance 2.0)、聲音卡、配樂 |
|---|---|
| LitVideo | EP13、EP14 的影片生成(Seedance 2.0 首幀模式) |
| OpenAI Codex | 場景定裝與每一鏡的靜態畫格 |
| Claude(Anthropic) | 分鏡整理、剪輯、字幕、六語翻譯、上架與官網 |
| Demucs+OpenVoice | EP13、EP14 的換聲(開源、在自己的電腦上執行) |
| Python+FFmpeg | 剪輯、字幕燒錄、混音的程式 |
看到這裡,你可能會覺得:好麻煩。是的。AI 省下的是錢和人力,省不下的是美感、審稿和判斷——哪一鏡的臉不對、哪一句台詞不像角色、哪個瑕疵可以放過、哪個一定要重拍,最後都得靠你自己決定。工具讓故事有機會被拍出來;拍得好不好,還是取決於說故事的人。
炎劍文化工作室 周明樺2026 年 10 月
看《秘書可芸,請指教》 Watch the series 讀導演後記 Director’s note
本劇純屬虛構;影像、聲音與部分配樂以 AI 生成技術製作,角色為原創虛構人物。 · Fiction. Images, voices and parts of the score were created with AI.